Si vous avez déjà extrait une liste de 500 comptes cibles chez un fournisseur de données et constaté que 30 % des contacts revenaient sans email, sans téléphone, voire sans les deux, vous connaissez déjà le problème que résout l’enrichissement en cascade.
La réponse habituelle consiste à accepter ce manque de couverture, ou à prendre un second abonnement et à comparer les résultats à la main. Aucune n’est une vraie solution. La première fait perdre des opportunités. La seconde fait perdre du temps et de l’argent. L’enrichissement en cascade est la réponse structurelle : chaque enregistrement passe par plusieurs fournisseurs à la suite, la recherche s’arrête dès qu’un résultat vérifié est obtenu, et vous ne payez que ce que vous obtenez réellement.
Cet article explique ce qu’est l’enrichissement en cascade, pourquoi il fonctionne et ce qu’il change concrètement pour les équipes outbound.
Ce qu’est l’enrichissement en cascade
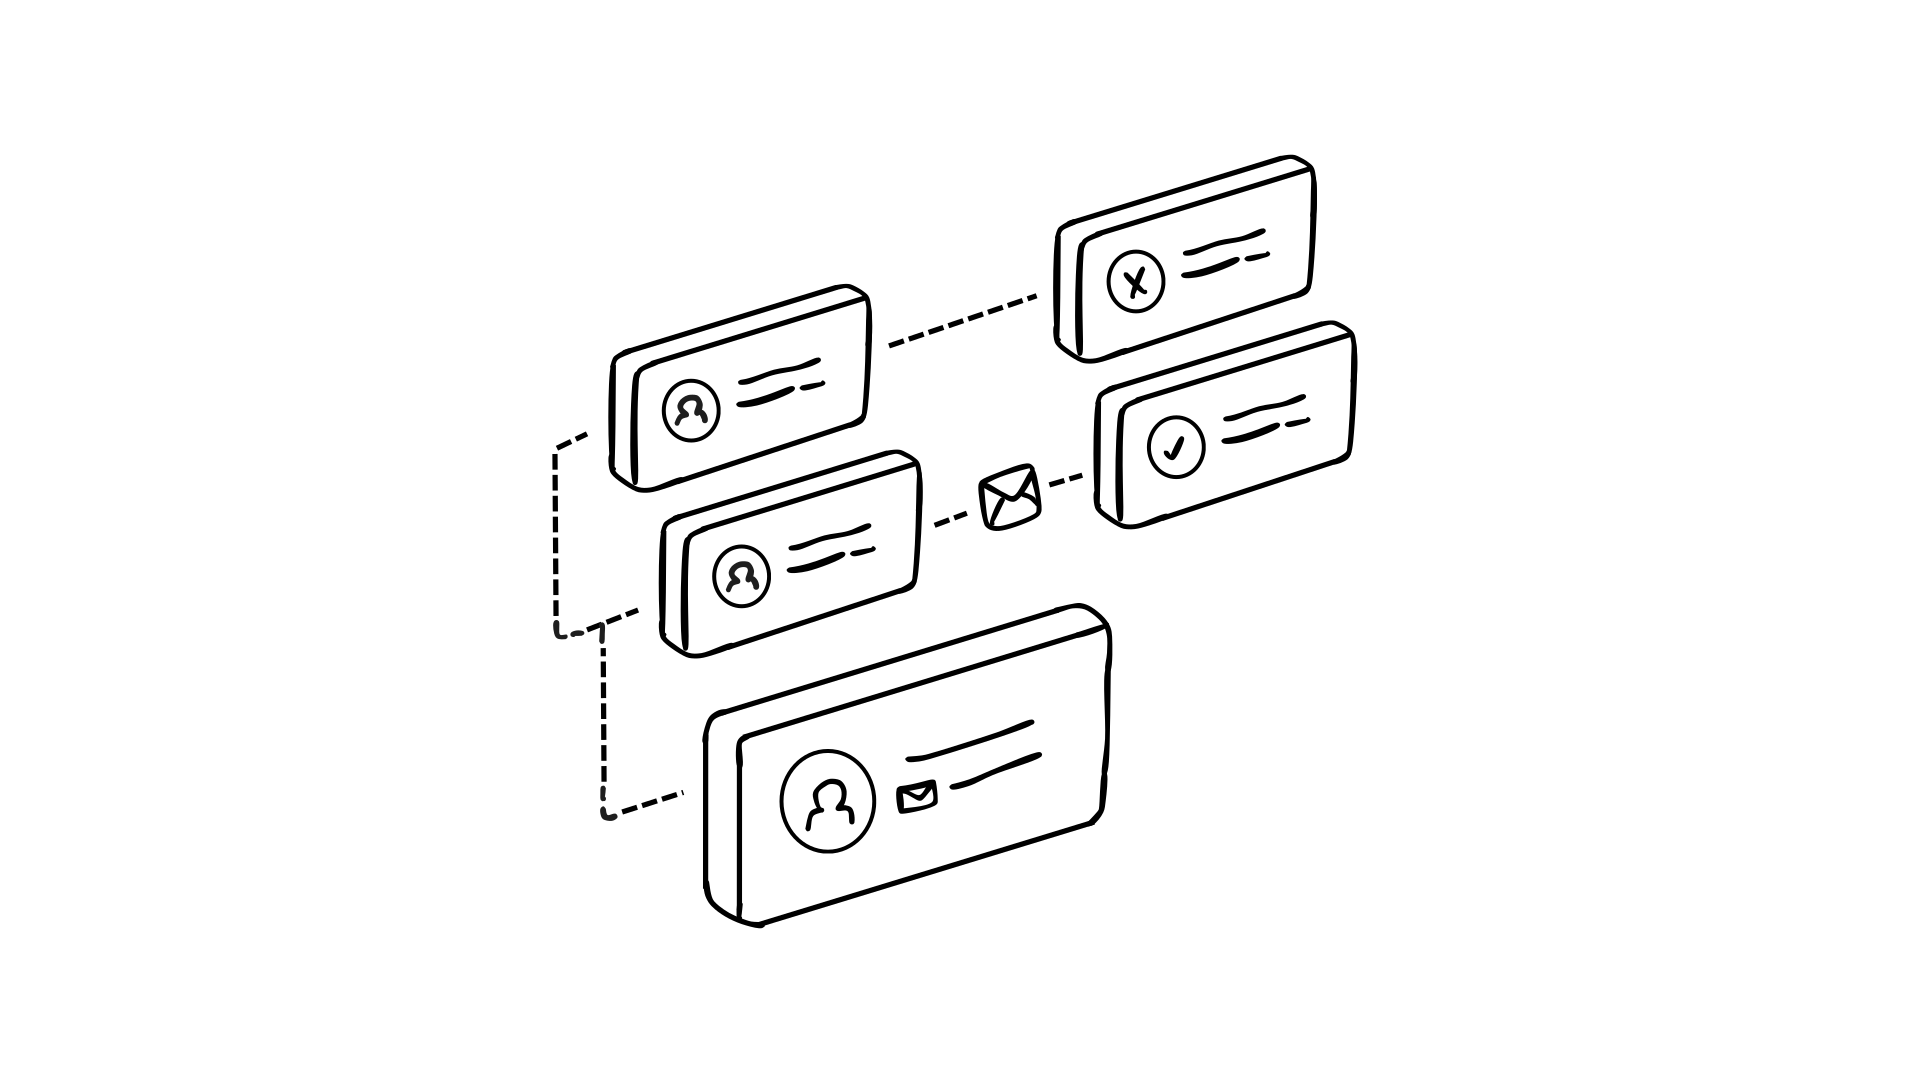
L’enrichissement en cascade est une stratégie de recherche de données séquentielle. Au lieu d’envoyer un contact à un seul fournisseur et d’accepter ce qu’il renvoie, vous l’envoyez à une liste ordonnée de fournisseurs, l’un après l’autre, et vous vous arrêtez dès qu’un résultat vérifié est renvoyé.
Le nom vient de la logique du processus : les données descendent d’un fournisseur à l’autre comme l’eau d’une marche à l’autre, et s’arrêtent à la première marche où quelque chose est trouvé. Chaque fournisseur ne voit que les enregistrements que le précédent n’a pas su résoudre.
La version la plus simple : vous cherchez le numéro direct d’un VP Sales dans une entreprise SaaS de taille moyenne en Allemagne. Vous envoyez la demande au fournisseur A. Le fournisseur A ne renvoie rien. L’enregistrement passe automatiquement au fournisseur B. Le fournisseur B renvoie un numéro mobile. La cascade s’arrête. Vous payez un résultat, pas deux tentatives.
Pourquoi la couverture d’un seul fournisseur ne suffit pas
Aucun fournisseur de données B2B n’a une couverture complète. Chacun construit sa base différemment : certains s’appuient sur le scraping de LinkedIn, d’autres sur des réseaux de vérification d’emails, d’autres encore sur les données des opérateurs téléphoniques ou l’exploration des registres d’entreprises. Chaque approche crée des angles morts.
Ces trous de couverture ne sont pas aléatoires. Ils sont structurels et prévisibles. Un fournisseur solide sur les contacts des grandes entreprises américaines peut avoir une faible couverture sur les PME européennes. Un fournisseur excellent sur les adresses email peut avoir peu de données téléphoniques. Un fournisseur qui a indexé massivement il y a deux ans peut avoir des données périmées sur les secteurs très mouvants comme les startups tech.
Le chiffre de 40 % n’a rien d’exceptionnel. Les références du secteur montrent régulièrement que même les fournisseurs les mieux couverts laissent des trous importants sur certains ICP, certaines zones géographiques et certains niveaux hiérarchiques.[1] Pour les équipes outbound qui ciblent les marchés européens, les régions non anglophones ou les entreprises de moins de 500 salariés, la couverture d’un seul fournisseur peut tomber bien en dessous de 60 % sur les téléphones.[2]
La conséquence est simple : toute équipe qui prospecte avec un seul fournisseur laisse systématiquement des contacts injoignables, non parce qu’ils sont introuvables, mais parce que son unique fournisseur ne les a pas.
Comment est structurée une cascade
Une cascade comporte trois éléments : une liste ordonnée de fournisseurs, une logique de routage et une étape de vérification. Chacun joue un rôle distinct.
La liste ordonnée de fournisseurs détermine quels fournisseurs sont interrogés et dans quel ordre. Ce classement n’est pas arbitraire : il reflète la précision de chaque fournisseur sur votre ICP, son coût par crédit et son temps de réponse. Un fournisseur précis et peu cher a sa place en haut de la liste. Un fournisseur qui trouve beaucoup mais avec moins de précision peut se placer plus bas, comme solution de secours plutôt que comme source principale.
La logique de routage détermine quand un enregistrement passe au fournisseur suivant. Dans la plupart des cas, il avance quand le fournisseur précédent ne renvoie rien, ou renvoie un résultat qui échoue à la vérification. Certaines implémentations permettent une avancée partielle : si le fournisseur A renvoie un email mais pas de téléphone, l’enregistrement passe au fournisseur B uniquement pour le téléphone.
L’étape de vérification se place entre les fournisseurs. Un résultat du fournisseur A n’est pas accepté d’office : son format, l’existence du domaine et, pour un email, sa délivrabilité sont vérifiés. Seuls les résultats vérifiés arrêtent la cascade. Un résultat non vérifié fait passer au fournisseur suivant, comme une absence de résultat.
Chaque fournisseur ne voit que les enregistrements que le précédent n’a pas su résoudre. Les crédits ne sont consommés que lorsqu’un résultat vérifié est renvoyé.
Pourquoi l’ordre des fournisseurs compte plus que leur nombre
Une idée reçue sur l’enrichissement en cascade veut que plus de fournisseurs donne automatiquement de meilleurs résultats. La couverture progresse bien avec chaque fournisseur ajouté, mais selon une courbe : les deux ou trois premiers fournisseurs trouvent la majorité des contacts trouvables, et chaque fournisseur supplémentaire apporte de moins en moins.
L’ordre dans lequel les fournisseurs sont interrogés compte autant que leur nombre. L’ordre optimal dépend de trois variables propres à votre cas d’usage.
La précision sur votre ICP
Le coût par résultat vérifié
La spécialisation par type de donnée
La fraîcheur et la fréquence de mise à jour
Ce que l’enrichissement en cascade change vraiment
Pour les équipes outbound, l’enrichissement en cascade change concrètement trois choses : la couverture, le coût par contact exploitable et la délivrabilité.
| Indicateur | Un seul fournisseur | Cascade (3 fournisseurs ou plus) |
|---|---|---|
| Couverture des téléphones | 55–65% | Jusqu’à 93 % |
| Couverture des emails | 65–75% | Jusqu’à 78 % |
| Coût par contact valide | Plus élevé (trous perdus) | Plus faible (on ne paie que les résultats) |
| Fraîcheur des données | Un seul cycle de mise à jour | Plusieurs cycles de rafraîchissement |
| Taux de rebond | Plus élevé (données non vérifiées) | Plus faible (vérification à chaque étape) |
Les chiffres de couverture du tableau reflètent des cascades réelles sur plusieurs combinaisons de fournisseurs. Les valeurs exactes varient selon l’ICP et la zone géographique, mais la tendance est constante : combiner trois fournisseurs ou plus porte la couverture à un niveau qu’aucun fournisseur n’atteint seul.[3]
La dynamique des coûts est contre-intuitive mais importante. Comme l’enrichissement en cascade ne facture que les résultats vérifiés, et non les tentatives infructueuses, le coût réel par contact exploitable est souvent inférieur à celui d’un fournisseur unique, même à prix du crédit identique. Vous arrêtez de payer pour les 30 à 40 % de requêtes qui reviennent vides.
Ce qu’il faut regarder dans une implémentation en cascade
Toutes les cascades ne se valent pas. Pour savoir si un outil met réellement en œuvre une logique en cascade, ou s’il interroge simplement plusieurs fournisseurs et renvoie le premier par ordre alphabétique, quatre éléments distinguent le vrai du superficiel.
Un ordre de fournisseurs configurable. Vous devez pouvoir classer les fournisseurs selon vos propres données, pas selon un ordre imposé par l’éditeur. Un éditeur qui place toujours son fournisseur principal en premier, quelles que soient vos données de performance sur votre ICP, ne vous propose pas une vraie cascade.
Une vérification à chaque étape. La cascade ne doit s’arrêter que lorsqu’un résultat passe la vérification, pas dès qu’un résultat quelconque est renvoyé. La nuance compte : un fournisseur qui renvoie un email syntaxiquement valide mais qui rebondit n’a pas produit un résultat réussi.
Une consommation de crédits transparente. Vous devez pouvoir voir quel fournisseur a résolu chaque enregistrement, combien de fournisseurs ont été interrogés avant d’obtenir un résultat et le détail du coût par enregistrement. Sans cela, impossible d’optimiser l’ordre des fournisseurs dans le temps.
Une logique de résolution partielle. Un contact comporte plusieurs champs : email, mobile, ligne directe, URL LinkedIn, intitulé de poste, niveau hiérarchique. Une cascade aboutie ne traite pas l’enregistrement de façon binaire. Si le fournisseur A trouve l’email mais pas le téléphone, l’enregistrement doit passer au fournisseur B pour le téléphone uniquement, et non être marqué comme complet.
Les équipes qui mettent correctement en place l’enrichissement en cascade constatent des améliorations constantes : plus de réponses, moins de rebonds et des SDR plus productifs, car leurs séquences atteignent de vraies personnes avec des coordonnées à jour, plutôt que des adresses valides il y a six mois dans une entreprise que la personne a quittée depuis.[4]
Le concept est simple. C’est la qualité de l’implémentation qui distingue une vraie amélioration de la couverture d’un argument marketing.